Intelligenzschicht von Spun
Tausende Nachrichten rein. Eine Antwort, immer aktuell.
Dein WhatsApp enthält die Antworten, vergraben in zehntausend Nachrichten. Mit Spun heftest du eine feste Frage an jeden Chat und jede Gruppe, und Spun hält die Antwort aktuell, während Nachrichten eintreffen, jede Aussage verknüpft mit den Nachrichten dahinter. Lies sie in der App, in deiner täglichen Zusammenfassung, auf deinem MCP-Dashboard oder über deine verbundene KI.
Jetzt live
Chat-Digests, das MCP-Dashboard und Digests in der täglichen Zusammenfassung sind in der Spun-App live, und die vier Digest-Tools sind auf der gehosteten MCP-Oberfläche live.
So funktioniert es
Einmal fragen. Dauerhaft beantwortet.
Ein Digest ist eine feste Frage an einen Chat, an mehrere oder an eine ganze Gruppe: „Was haben wir mit diesem Lieferanten vereinbart?“, „Welche Beschwerden sind noch offen?“. Spun arbeitet neue Nachrichten in die Antwort ein, sobald sie eintreffen; du musst nie erneut fragen.
1 · Frage festlegen
Wähle einen Chat oder eine Gruppe, gib die Frage ein, wähle die Sprache der Antwort und wie oft sie aktualisiert wird. Du siehst eine Kostenschätzung, bevor es den Digest überhaupt gibt.
2 · Spun hält sie beantwortet
Neue Nachrichten fließen inkrementell in die Antwort ein. Regelmäßige vollständige Neuaufbauten lesen das Zeitfenster von Grund auf neu, sodass veraltete Schlüsse ersetzt werden, statt sich anzuhäufen.
3 · Sofort lesen
Beim Öffnen eines Digests kommt die vorbereitete Antwort: kein Warten auf ein Modell, keine Überraschungskosten. Eine vorzeitige Aktualisierung ist immer eine ausdrückliche, sichtbare Aktion.
Geschwindigkeit
Vorbereitet schlägt auf Abruf
Die schnellste KI-Antwort ist die, die schon bereitlag, bevor du gefragt hast. Genau darauf ist diese ganze Schicht aufgebaut.
Sofort, aus Prinzip
Digests, Karten und Zusammenfassungen werden im Voraus vorbereitet: Eines davon zu öffnen ist ein Lesezugriff auf die Datenbank, kein Modelllauf. Kein Ladekreisel, keine dreißig Sekunden „Nachdenken“.
Verlauf in Millisekunden lesen
Antworten und ihre Belege werden aus dem indizierten Verlauf deiner Organisation aufgelöst: volle Tiefe, im Millisekundenbereich, selbst wenn die WhatsApp-Nummer offline ist.
Schnellere Agenten, weniger Aufrufe
Eine KI, die eine vorbereitete Antwort liest, braucht einen einzigen Tool-Aufruf, wo ein Agent mit roher API Hunderte Nachrichten Seite für Seite durchgeht: schnellere Antworten, kleinere Token-Rechnungen.
Chat-Digests
Feste Fragen, mit Belegen gestützte Antworten
So viele Fragen pro Chat oder Gruppe, wie du willst. Antworten werden inkrementell aktualisiert (nur neue Nachrichten verbrauchen Tokens) und regelmäßig von Grund auf neu aufgebaut, damit sich die Antwort nie von der Unterhaltung entfernt.
Viele Fragen pro Chat
Eine Lieferantengruppe kann „offene Zusagen“, „Preisänderungen“ und „Lieferprobleme“ nebeneinander tragen: Jeder Digest verfolgt seine eigene Frage, nach seinem eigenen Zeitplan.
Fortlaufend, nicht neu berechnet
Jede Aktualisierung arbeitet nur die neuen Nachrichten in die feste Antwort ein, sodass auch ein lebhafter Chat bezahlbar bleibt. Geplante Neuaufbauten zur Verankerung leiten die Antwort neu aus den Rohnachrichten ab.
„Warum sagt Spun das?“
Jede Aussage in einer Antwort verweist auf die Quellennachrichten dahinter. Tippe auf einen Verweis, um die Originalnachricht zu sehen: Die Antwort ist überprüfbar, nicht nur plausibel.
Abdeckung, ehrlich angegeben
Jede Antwort sagt, was sie sich angesehen hat: „412 Nachrichten analysiert, 9 zitiert“. Du weißt immer, wie viel von der Unterhaltung hinter dem steht, was du gerade liest.
Deine Sprache, deine Formulierung
Antworten werden in der Sprache geschrieben, die du pro Frage wählst: Führe einen englischsprachigen Betrieb über hebräische Chats, oder umgekehrt.
Geprüft vor dem Speichern
Kundennachrichten sind nicht vertrauenswürdige Eingaben. Antworten werden geprüft, bevor sie gespeichert werden, erfundene Verweise werden verworfen, und regelmäßige Neuaufbauten entfernen alles, was nicht hätte bestehen bleiben dürfen.
Tägliche Zusammenfassung
Jetzt liveDeine Digests in deinem Morgenüberblick
Spun schickt dir bereits eine tägliche Zusammenfassung dessen, was in deinem Posteingang passiert ist. Markiere einen beliebigen Digest mit „In die tägliche Zusammenfassung einbeziehen“, und seine aktuelle Antwort erscheint als Abschnitt dieses Überblicks: deine festen Fragen, jeden Morgen beantwortet, in dem Kanal, den du ohnehin liest.
Das MCP-Dashboard
Jetzt liveSpeichere deine häufigen Anfragen. Lade sie sofort.
Die Anfragen, die du über MCP immer wieder stellst („Was haben wir vereinbart?“, „Wer wartet auf uns?“), werden zu festen Karten auf dem MCP-Dashboard: Digests, Signale aus der Gruppenintelligenz, Freigaben für KI-Sendungen, Follow-ups und fällige Aufgaben. MCP verwaltet die Intelligenz, das Dashboard liefert sie aus. Eine Karte öffnet sich sofort, ohne Modellaufruf und ohne MCP-Roundtrip, weil die Antwort schon vorbereitet war, bevor du kamst.
Konfigurierbare Karten
Digests, Signale aus der Gruppenintelligenz, Freigaben für KI-Sendungen, die auf einen Menschen warten, Follow-ups und fällige Aufgaben: ein- und ausblenden, neu ordnen, hinzufügen und entfernen, für jede Person einzeln.
Eine Aufmerksamkeitsleiste
Der obere Teil der Seite beantwortet eine einzige Frage: Was braucht gerade einen Menschen? Ausstehende Freigaben, Signale mit hoher Dringlichkeit, überfällige Follow-ups.
Aktualität, ehrlich
Jede Karte gibt an, wie frisch ihre Intelligenz ist (frisch, älter oder stark veraltet), und ein Digest im Neuaufbau sagt das auch. Das Dashboard stellt alte Intelligenz nie als aktuell dar.
Laden ohne KI-Latenz
Das Öffnen des Dashboards löst nie einen Modellaufruf aus. Alles auf dem Bildschirm wurde im Voraus vorbereitet; einen Digest zu aktualisieren ist immer deine ausdrückliche Aktion, mit angezeigten Kosten.
Standardlayouts der Organisation
Ein Manager speichert den Team-Standard; neue Mitglieder starten damit, und jede Person kann ihn anpassen oder darauf zurücksetzen.
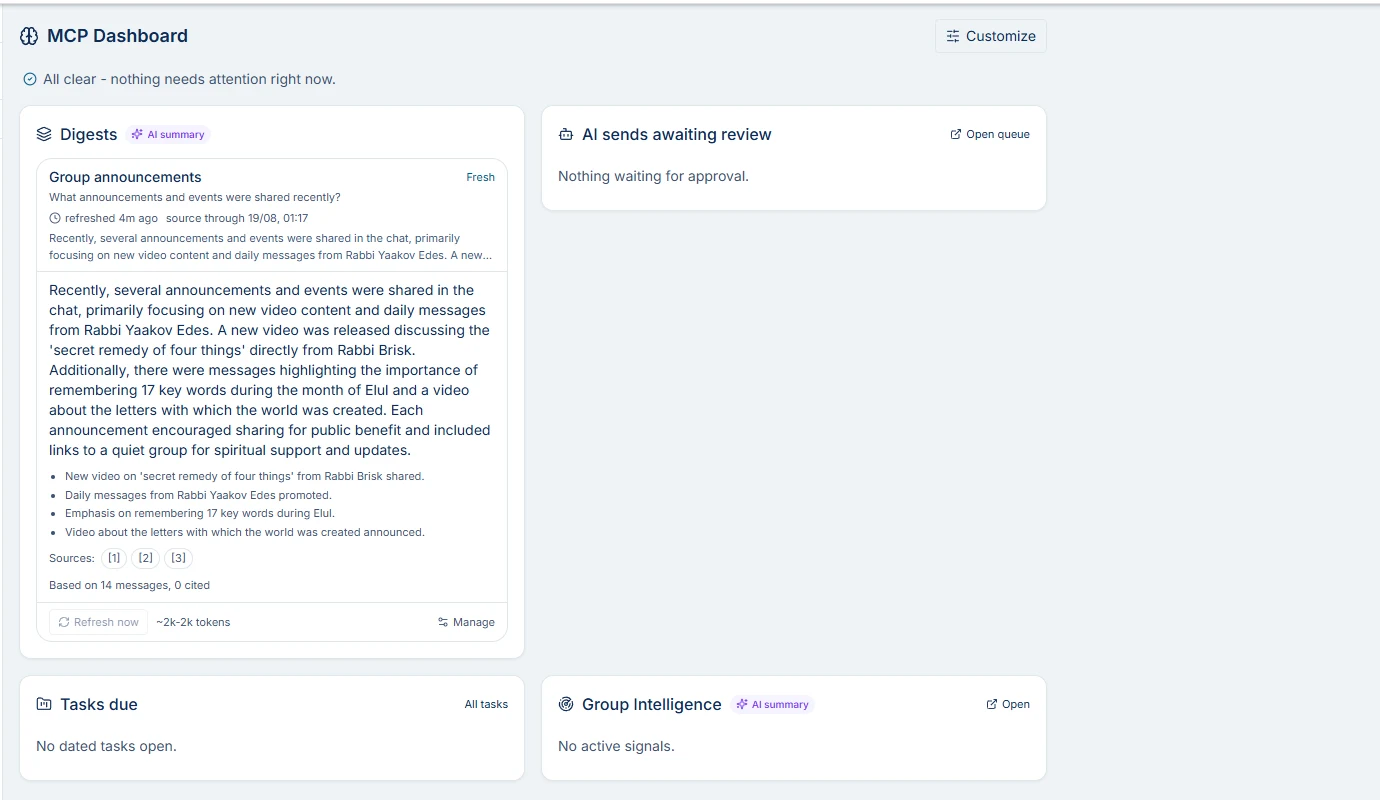
Das MCP-Dashboard im Spun-Posteingang: ein echter Screenshot, samt Digest-Antwort.
Ein Manager legt das Standardlayout für das Team fest; jede Person kann darauf aufbauend ihr eigenes anpassen.
Verwaltet über MCP. Lesbar ohne MCP.
Die beiden Oberflächen sind ein System: Deine KI pflegt die Intelligenz, das Dashboard liefert sie vorbereitet aus. Das kannst du auf jeder Seite tun:
Aus deiner KI, über MCP
Digest-Tools live- Eine neue feste Frage an jeden Chat oder jede Gruppe heften
define_chat_summary - Jede vorbereitete Antwort sofort lesen
get_chat_summary - Rund um eine Antwort mit den Live-Tools recherchieren: Suche im Verlauf, die Follow-up-Warteschlange, Kontakte und Kampagnen
- Das Follow-up entwerfen, das ein Digest nahelegt, direkt in die Freigabe-Warteschlange
Im MCP-Dashboard, im Spun-Posteingang
- Jeden Digest erstellen, bearbeiten, pausieren, aktualisieren oder neu aufbauen und auf eine frühere Version zurücksetzen
- Die Kostenschätzung sehen, bevor es eine Frage gibt, und während sie läuft den tatsächlichen Verbrauch daneben
- Karten ein- und ausblenden, neu ordnen, hinzufügen und entfernen; Manager speichern das Standardlayout für das Team
- Ausstehende KI-Sendungen freigeben oder ablehnen und die Belege hinter jeder Aussage öffnen
Eingebaute Integrationen
Ein Dashboard für alle Systeme, die du schon nutzt
Das MCP-Dashboard ist kein weiteres Silo: Jede Karte ist ein Fenster in ein Spun-System, das bereits für dich arbeitet:
Gruppenintelligenz
Dringende Gruppensignale erscheinen als eigene Karte, neben deinen Digests.
Tägliche Zusammenfassung
Digests lassen sich in den Überblick aufnehmen, den du schon jeden Morgen bekommst.
Freigaben für KI-Sendungen
Die Freigabe-Warteschlange ist eine Karte: Reine Textsendungen gibst du mit zwei Tipps frei, alles andere führt per Link weiter.
Follow-up-Warteschlange
Die ältesten unbeantworteten Unterhaltungen und die, die auf dich warten, direkt neben der Intelligenz.
Aufgaben & Projekte
Deine offenen Aufgaben mit Datum, überfällige zuerst, auf demselben Bildschirm.
Zugriff über Team Share
Eingeschränkte Mitglieder und Partner sehen nur die Karten, die ihr Zugriffsbereich zulässt.
In-App-Assistent
Der integrierte Assistent von Spun liest deine Digests, wenn du ihm Fragen stellst.
MCP-Clients
claude.ai, Cursor und jeder MCP-Client: Digest-Tools auf der gehosteten Oberfläche.
Teilen
Zeig Kunden die Intelligenz, nicht den Posteingang
Digest-Antworten lassen sich über denselben eingegrenzten Zugriff teilen, den dein Team-Posteingang schon nutzt. Ein Kunde oder Partner mit eingeschränktem Zugriff sieht einen Digest nur, wenn jeder Chat, der ihn speist, in seinem Zugriffsbereich liegt; andernfalls hält Spun die ganze Antwort zurück, statt eine teilweise geschwärzte auszuliefern.
Betrachter lesen vorbereitete Antworten. Das Ansehen eines Digests löst nie KI-Arbeit aus und verbraucht nie dein KI-Budget.
Kostentransparenz
Kenne den Preis, bevor du die Frage stellst
KI, die du nicht budgetieren kannst, ist KI, die du abschaltest. Jeder Digest zeigt seine Kosten, bevor es ihn gibt, und meldet im laufenden Betrieb, was er tatsächlich verbraucht hat.
Eine Schätzung vor dem Erstellen
Beim Erstellen einer Frage siehst du eine Token-Spanne pro Aktualisierung und pro Monat, berechnet aus der jüngsten Aktivität des Chats. Die Schätzung folgt der aktuellen Aktivität: Wird der Chat lebhafter, steigt der Verbrauch entsprechend, und die Oberfläche sagt genau das.
Tatsächlicher Verbrauch, daran gemessen
Jeder Digest erfasst, was er tatsächlich verbraucht. Ein Digest, der seine Schätzung deutlich überschreitet, bekommt einen sichtbaren Überschreitungshinweis, keine stille Rechnung.
Automatische Pausen als Schutz
Ein Digest-Budget pro Organisation verlangsamt Aktualisierungen, je knapper es wird, und stoppt sie an der Obergrenze. Digests, die niemand liest, pausieren sich selbst, bevor sie mehr verbrauchen, und sagen dir das, wenn du zurückkommst.
Vom Lesen zum Antworten
Intelligenz, die in einer freigegebenen Nachricht endet
Ein Digest sagt dir, dass ein Kunde auf ein Angebot wartet. Der nächste Schritt sollte nicht Scrollen sein. Bitte den Assistenten zu handeln, und der Ablauf bleibt den ganzen Weg über geregelt:
1 · Die Zusammenfassung lesen
Der Digest zeigt die Lage: wer wartet, worauf, seit wann.
2 · Die Belege holen
Verweise öffnen genau die Quellennachrichten, damit du oder deine KI vor dem Handeln prüfen könnt.
3 · Die KI entwirft die Antwort
Der Assistent bereitet die Nachricht vor, samt Absenderkanal und der von ihm angegebenen Begründung.
4 · Ein Mensch gibt frei
Der Entwurf wartet in der Freigabe-Warteschlange, bis ein Teammitglied ihn freigibt; dann sendet der Server ihn.
Der Entwurf landet in der Freigabe-Warteschlange für KI-Sendungen, mit dem echten Kanal, Empfänger und Inhalt. Nichts wird gesendet, bevor ein Mensch mit Sendeberechtigung ihn freigibt: derselbe Versandablauf, der jede KI-Sendung in Spun regelt.
Zugriff über MCP + API
Auf der MCP-OberflächeDeine verbundene KI liest dieselbe Schicht
Alles auf dieser Seite sind Daten, mit denen dein Assistent arbeiten kann. Verbundene KI-Apps (claude.ai, Claude Code, Cursor oder jeder MCP-Client) erreichen deinen Spun-Arbeitsbereich schon heute über den MCP-Server von Spun, und eigene Digest-Tools gehören zu dieser Oberfläche:
| get_chat_summary | Die aktuelle Antwort eines Digests lesen: die vorbereitete, mit Belegen verknüpfte Zusammenfassung, sofort ausgeliefert. |
| define_chat_summary | Eine feste Frage an einen Chat anlegen, mit demselben Zugriffsbereich, demselben Budget und denselben Freigaberegeln wie alles andere. |
Toolnamen auf der MCP-Oberfläche; dieselben Fähigkeiten treiben den In-App-Assistenten an. Digests gibt es außerdem in der Spun-App und in der täglichen Zusammenfassung; deine per MCP verbundene KI hat insgesamt 97 Tools.
Governance
Intelligenz, die du einer KI anvertrauen kannst, und zwar sicher
Diese Schicht gibt es überhaupt nur, weil sie von Anfang bis Ende geregelt ist. Das ist der Unterschied, und er ist strukturell, kein Versprechen:
Menschliche Freigabe bei jeder Sendung
Intelligenz kann in Handlung münden, aber die Handlung durchläuft die Freigabe-Warteschlange für KI-Sendungen. Standardmäßig erreicht nichts einen Kunden, ohne dass eine Person den tatsächlichen Inhalt freigibt.
Der Lesebereich ist Richtlinie der Organisation
Digests sehen nur, was der KI-Lesebereich deiner Organisation zulässt: Die Kanal-Allowlist, die Label-Regeln und der Gruppenschalter gelten für feste Fragen genauso wie für jeden anderen KI-Lesezugriff.
Der Zugriffsbereich wird bei jedem Lesen neu geprüft
Verlässt ein Chat den Zugriffsbereich einer betrachtenden Person, wird ihr die darauf aufgebaute Antwort schon beim nächsten Lesen vorenthalten, nicht erst bei der nächsten Aktualisierung.
Von Grund auf gegen Injection gewappnet
Kundentext wird als nicht vertrauenswürdig gekennzeichnet, bevor ein Modell ihn liest. Digest-Antworten werden vor dem Speichern geprüft, Verweise werden mit den tatsächlich gelesenen Nachrichten abgeglichen, und Neuaufbauten zur Verankerung entfernen Rückstände.
FAQ
Intelligenzschicht von Spun: häufige Fragen
Schluss mit dem Nachlesen. Fang an zu fragen.
Hefte deine erste feste Frage an deinen aktivsten Chat, und lass die Antwort von selbst aktuell bleiben.
Jetzt starten